字数:约2800字 | 阅读时间:8分钟 “索引烧了可以重建,正本烧了就什么都没了。”
「记忆工程」系列第二篇。上一篇讲了为什么要给 AI 造一个"第二大脑",这一篇往下挖一层:记忆到底长什么样,为什么必须能 diff,以及四条底线是怎么一条条落进代码里的。
一、先说清楚"正本"是什么
上一篇发出去之后,被问得最多的问题是:向量库、嵌入式数据库、各种记忆框架都有,为什么偏要从"一堆文件加一个 Git 仓库"开始?
先给结论:我们要的不只是“存得下”,更要"毁不掉"。
所谓正本,就是把所有派生物全删掉之后还剩下的那份东西。embedding 索引删了,可以从 Markdown 重建;缓存删了,可以重新生成。这些都可以坏,坏了重跑就行。但 Markdown 和 Git 历史要是没了,整个系统就只剩一个空壳。反过来,只要这两样在,索引层随便推倒重来,十分钟满血复活。
这个设计被真实场景检验过。项目进行中,本机的记忆仓库被一次强制重置打翻,AI 在巡检报告里提示了异常。最后我们是靠 Git 的操作日志(reflog)把现场完整恢复的——那些记忆要是存在某个私有数据库里,那次大概率就是永久丢失,连"去哪找"都不知道。
记忆系统天然处在各种自动化程序的写风险之下:AI 会写错,脚本会写崩,重置会误伤。把正本放在最笨、最老实、二十年不会过时的格式上,就是给整个系统设了一个止损下限。
二、骨架:三种记录
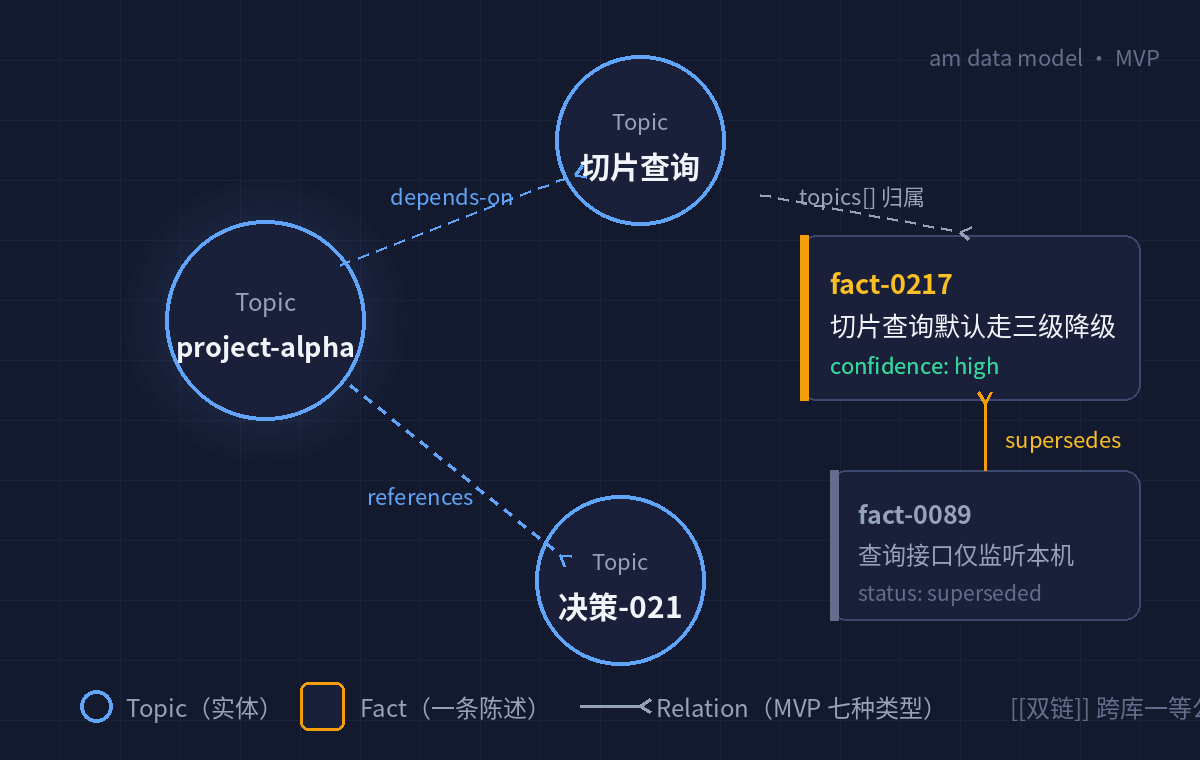
结论先行:整个记忆库只有三种记录——Topic、Fact、Relation。
**Topic 是实体节点。**一个项目、一个工具、一次会话、一个设计决策,都是 Topic。它是记忆图里"名词"的部分。
Fact 是关于某个 Topic 的一条离散陈述。“切片查询默认走三级降级"是一条 Fact,“查询接口只监听本机"也是。每条 Fact 独立存在,独立带状态,独立过期。
**Relation 是带类型的边。**MVP 只留了七种:depends-on、part-of、belongs-to、authored-by、references、conflicts-with、supersedes。
为什么只留七种?因为实际运行里我们观察到一个现象:关系类型一旦放开,AI 就开始发明关系——“somewhat-related-to"这种模糊边一多,图就废了,查询时全是噪音。宁可类型少,也要收敛。
三、一条事实的解剖
空谈模型容易飘,看一条真实的记忆。这是演示库里的一条 Fact(commit 哈希做了截断):
---
type: fact
id: fact-alpha-getuser-main
topics: [project-alpha]
status: active
confidence: high
provenance: demo-seed
repo: …/project-alpha
version: main
commit: 1a2b3c4
axis: subject
---

Alpha 在 main 分支只提供 getUser(id) 单点查询,无限流。
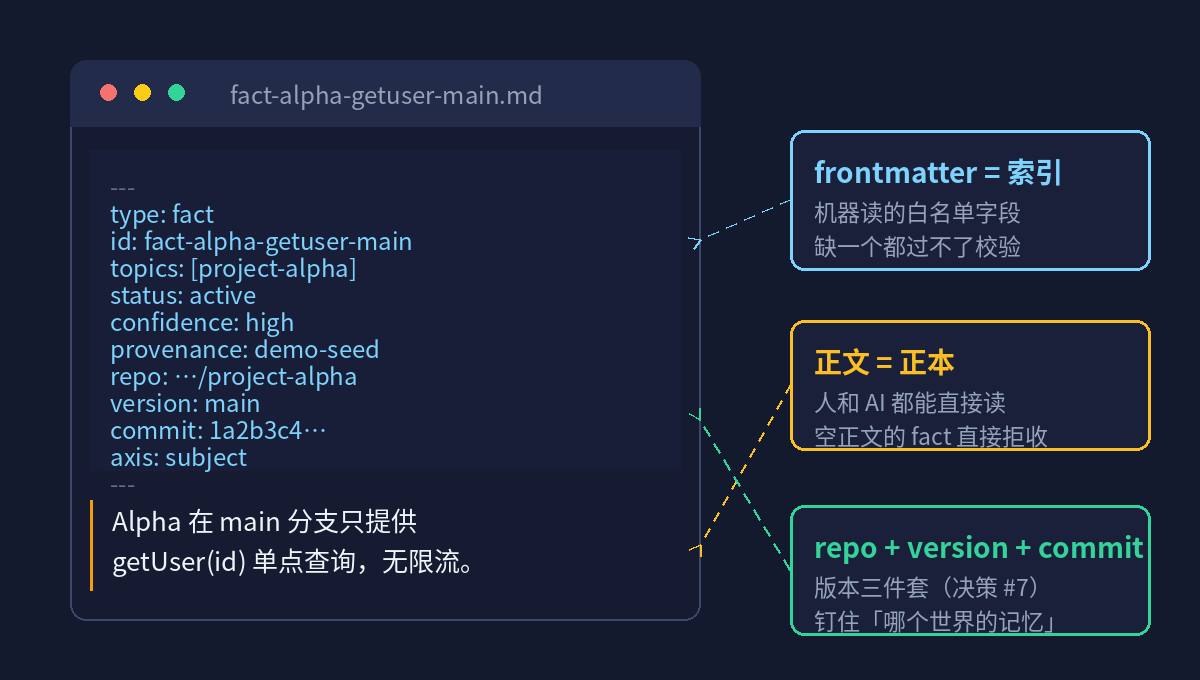
前面这几行 frontmatter 是机器读的索引:id 是唯一编号,topics 声明这条事实挂在哪些实体上,status 是生命周期状态(active / expired / superseded / contested / pending-review),confidence 是置信度,provenance 记来源。
重点说下面这三行:
repo: …/project-alpha
version: main
commit: 1a2b3c4
这是版本三件套,把"这条记忆说的是哪个世界的哪一刻"钉死了。version 是分支标签,它会漂移——分支可以被改名、被删除、被重新指向;commit 是不可变哈希,永远不会漂移。两个放在一起,一条记忆才算真正有了锚点。
最后那个 axis: subject 是个防混淆标记:它声明这条事实描述的是"被记忆对象”(项目代码库)的版本,而不是记忆库自身的版本。这两个东西极易搞混,先用一个字段在入口处挡住。这个话题水很深,是下一篇的主角。
四、frontmatter 是索引,正文才是正本
schema 里有一条看起来很拧巴的规定:frontmatter 只是机器可读的索引,正文才是唯一事实来源。一条 Fact 的正文如果是空的,直接拒收——哪怕 frontmatter 填得再完整也没用。
为什么这么狠?
因为我们见过太多系统顺着一条滑坡烂掉:机器字段先变成"更方便的数据源”,然后人就不读原始内容了,再然后原始内容就没人维护了,最后整个系统退化成另一个黑盒数据库——只不过碰巧用 Markdown 存储而已。空正文拒收,等于在入口处把"没有正文的记忆"这种半成品挡在库外,保住"人能直接读"这条命脉。
这条原则在工程上还配了一条硬红线:所有新增功能,默认路径下的输出必须与改动前逐字节一致(byte-identity),并且有专门的回归测试盯着。功能可以随便加,正本契约不能破。
五、整条链路上,大模型是可选件
这是数据模型里我个人最得意的一个决定:解析、校验、查询、过期检测,整条核心链路没有一步是必需大模型的。
YAML 解析是确定性代码,校验是白名单制的(字段名不在清单里就报错),查询是图遍历,过期检测靠状态机。“零必需 LLM"写在设计原则里,也被测试钉死在代码里——目前近 400 个自动化测试,没有一个依赖模型。
那大模型在哪?只有一个位置:把会话内容变成 Fact 草稿。草稿必须过 schema 校验才能进库:字段缺了、类型不对、正文为空,拒收。模型写得再天花乱坠,进不了库就不算记忆。
这个选择直接决定了系统的可靠性下限。模型抽风的时候,记忆系统该存存、该查查,只是暂时没有新记忆进来;索引层挂了,从 Markdown 全量重建;整套系统换模型、降级模型、甚至完全离线,照常运行。每一层都能独立失败,互不拖累。
顺便还有个隐含好处:成本可控。日常读写走的是纯程序,只有"提取新事实"这种真正需要理解力的环节才请模型出场。
六、四条底线,各自落在哪
首篇列过四条底线,这里交代它们的落点。底线这个东西,写在文档里谁都会,关键看违反它的事在代码里到底会不会发生:
| 底线 | 代码里的落点 |
|---|---|
| 明文 Markdown 是唯一正本 | 空正文拒收;所有索引可从正本全量重建 |
| 每次变更都是一次 commit | 记忆库本身就是 Git 仓库;reflog 止损有真实战例 |
| 工作区隔离 | 一项目一 vault,物理隔离;MVP 单库运行,多库接口先留好 |
| 跨库一等链接 | [[双链]] 语法;链接解析由系统自己的 id 层负责,不指望第三方工具 |
四条没有一条是玄学,每条都对应一个具体的校验器、一个具体的拒收条件,或者一个已经救过命的机制。
七、下一篇
数据模型里还埋着全项目最反直觉的一个设计:记忆也有版本号。同一条事实在 main 分支和 feature 分支上可以是两句话,查询时按你站的位置精确返回该版本的记忆——“版本切面查询”。
这个设计为什么长这样、被蓝队评审怎么折腾的、实际效果如何,下一篇《记忆也有版本号:双版本轴与版本切面》拆开讲。
照例:本文由 AI 起草、人类审校拍板。这个栏目本身,就是这个项目的人机协作现场记录。
「记忆工程」系列 · 02 | 上一篇:给AI建一个"第二大脑”:am项目立项